一群 AI 四小时重写了数据库,通过了全部测试——然后它慢了两万倍
🔍 复盘案例同一件事,我看到了两个版本。
第一个版本是:Cursor 团队让一群 AI Agent 从零重写 SQLite——不给源码,不给测试,不许联网,手里只有一本 835 页的官方手册。四个小时后,它们写出的 Rust 版本通过了 sqllogictest 的全部用例。
第二个版本是:有人拿 LLM 生成的 SQLite 跑了个再普通不过的查询——从表里取 100 行主键——它比原版慢了大约两万倍。
这两个版本都是真的。而大部分人只看到了其中一个。
我想把中间被省略的那一段补上。因为它决定了你该拿这条新闻去改什么决策,以及不该改什么。
先说我的判断:这次实验真正被推进的是「编排」,不是「模型能力」。而它之所以能成立,恰恰因为它绕开了真实工程里最难的那一步。
一、这场实验到底做了什么
先把事实摆清楚,它比传言有意思得多。
任务设计得非常“干净”:目标是 SQLite,输入只有那本 835 页的官方手册,环境隔离——没有源码可抄,没有现成测试可对,没有网络可查。验收用 sqllogictest,一个 SQL 逻辑测试集,Agent 事先看不到。
跑法也不是“一个大模型埋头写”,而是一支分工明确的队伍:
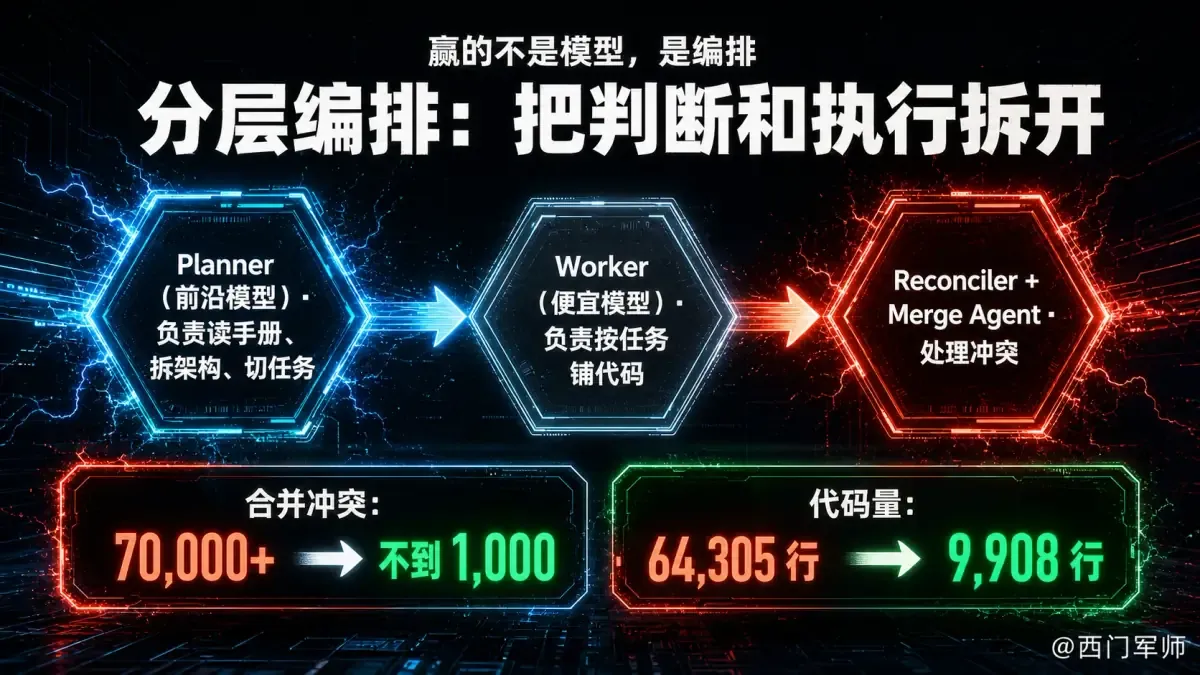
- Planner 用前沿模型,负责读手册、拆架构、切任务;
- Worker 用便宜模型,负责按任务铺代码;
- 中间加了 Reconciler 和一个第三方 Merge Agent,专门处理冲突;
- 再加一份共享的 Field Guide,让所有 Agent 对齐同一套约定。
结果是四小时内通过率冲到八成上下,此后所有新配置最终都跑到了 100%。
但真正让我停下来的不是通过率,是另外两个数字:
合并冲突从旧方案的 70000 多次,降到这次实验的 1000 次以内。代码量从旧混合方案的 64305 行,压到 9908 行。
二、赢的不是模型,是编排
冲突数从七万降到一千,这件事和“模型变聪明了”关系不大。
它是流程设计的结果:把判断和执行拆开,把冲突交给专职角色,把共享约定写成一份所有人都读的文档。这套东西在人类团队里叫工程管理;放到 Agent 集群上,Cursor 管它叫 Harness Engineering——不改模型,改模型外面那层脚手架。
分层编排:把判断和执行拆开
成本数据把道理说得更直白:
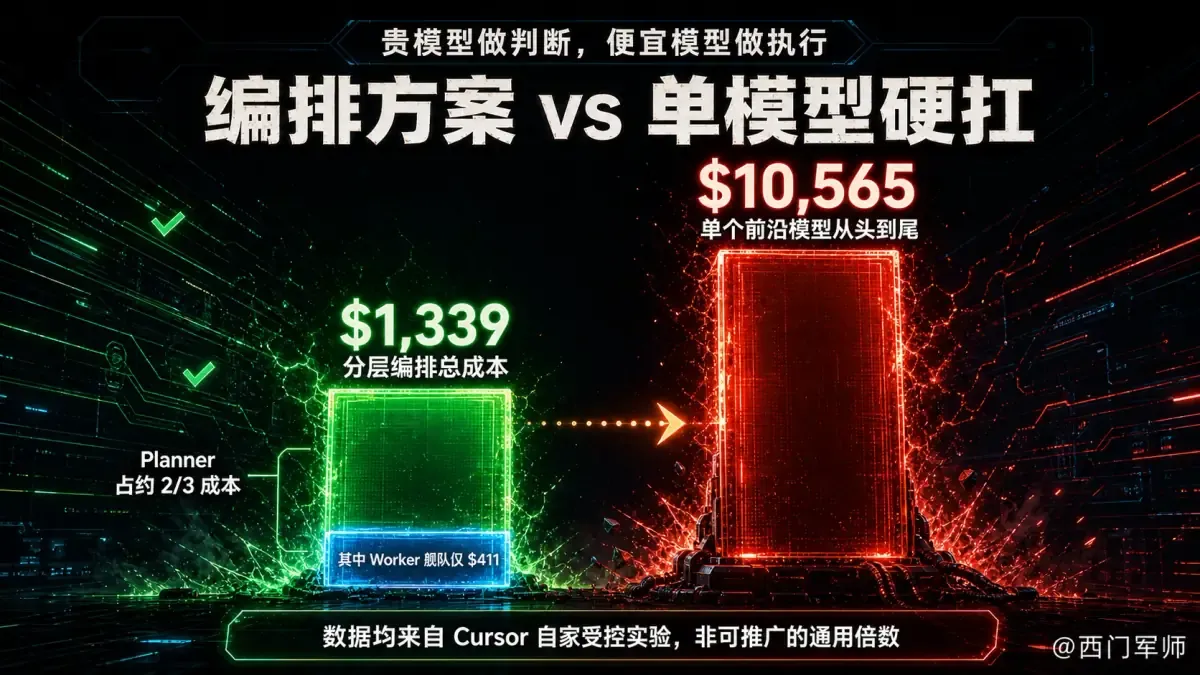
- 前沿模型当 Planner + 便宜模型当 Worker,总成本 1339 美元,其中整支 Worker 舰队只花了 411 美元;
- 换成单个前沿模型从头扛到尾,10565 美元。
更值得琢磨的是内部结构:Planner 产出的 token 在总量里占比很小,却吃掉了大约三分之二的成本。也就是说,钱几乎全花在“想清楚”上,而不是“写出来”上。
贵模型做判断,便宜模型做执行——这是我从这次实验里拿走的、最可能马上用得上的一条结论。
编排方案 vs 单模型硬扛:成本对比
但得钉一句:这两个数字都来自 Cursor 自家的受控实验,任务单一、规范固化,也不清楚是否算进了人工监督和排错重试的开销。它是一个有说服力的方向,不是一个可以拿去做预算的倍数。谁把它写成“用 AI 编排能省 15 倍成本”,谁就是在编。
三、然后,它慢了两万倍
现在说另一半。
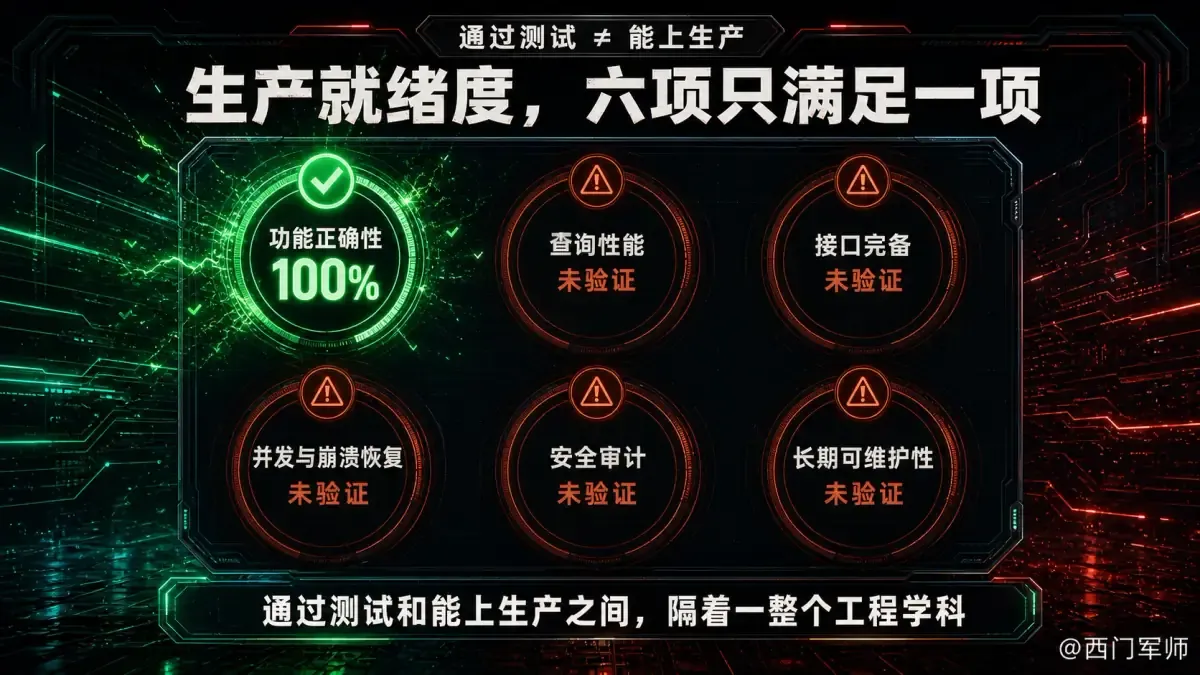
在独立基准测试里,LLM 重写版的 SQLite 在 100 行主键查询这种场景下比原版慢约两万倍。原因不神秘:缺查询优化器,缺索引策略,缺执行引擎层面的优化——而这些恰恰是原版 SQLite 打磨了二十多年、真正难的部分。
再看生成物本身。那个仓库没有 CLI,没有 C API 导出,没有预编译接口,没有跨进程文件锁,只支持进程内并发。换句话说,你没法把它当成 SQLite 装进任何一个真实系统——接口那一层压根不存在。
那 100% 的测试通过率算什么?它是真的,但它测的是SQL 语句返回的行结果对不对。它不测 C API,不测操作系统级文件锁,不测复杂并发,不测崩溃恢复,不测安全审计,更不测这套代码三年后还能不能维护。
这就是业内说的“80% 问题”:AI Agent 能极快地把功能推到 80%,剩下的 20%——错误处理、安全、可观测性——被留在了长期维护的账单上。而对数据库这种东西,那 20% 才是它之所以是数据库的原因。
生产就绪度,六项只满足一项
Cursor 自己其实没把话说满,官方把它定位成一次概念验证。反倒是转述链条上的每一层,都把“通过了全部测试”往“可以替代 SQLite”的方向推了一点。
通过测试和能上生产之间,隔着一整个工程学科。
四、被跳过的那一步,才是真实工程里最难的
聊到这儿,多数讨论就停在“AI 还不行”或者“AI 已经很行了”。我觉得两边都没说到点上。
这次实验最值得注意的,是它成立的前提。
835 页官方手册,意味着“要造什么”被钉死到了几乎没有歧义的程度。sqllogictest,意味着“造对了没有”可以被机器自动判定,每次提交都能拿到密集反馈。
这两个条件,在真实产品工程里几乎从不同时出现。
真实工程里最贵的一步从来不是“怎么造”,而是“确定要造什么”——需求是模糊的,约束是边做边冒出来的,验收标准往往到上线前一天还在改。一个规范完备、验收自动的任务,本身就是稀缺品。
而这正是危险的地方:**目标越确定,Agent 集群越强;目标越模糊,它们只会更快地跑向一个错误的答案。**七万次冲突降到一千次,前提是所有人朝同一个方向跑。方向错了,高效协同只会让你更快地拿到一个精致的错误结果。
Swarm 在这次实验里最大的优势,换个场景就是最大的劣势。
五、那这条新闻,你该怎么用
如果只给一条能立刻执行的判断,我会这么说:
先别问该不该上 Agent 集群,先问你手里这个任务有没有一套机器能自动判对错的验收标准。
有——比如协议实现、格式转换、接口迁移、按明确规范做的重构:规范写得下来,结果测得出来,错了可以整批丢掉重跑。这类任务正是这次实验直接照到的地方,值得认真试一次分层编排,而且优先试“贵模型规划、便宜模型执行”的组合。
没有——需求还在变,验收还得靠人肉看。那你要补的是规范和测试,不是 Agent 数量。在这种任务上加 Agent,等于给一辆方向未定的车换更大的发动机。
至于让 Agent 直接去动生产环境的数据库和后端服务,开发者社区已经有不少明确的反对声音,安全和稳定性上的风险是实打实的。企业级本地化部署这件事,目前公开材料里能找到的只有理论框架——安全运行时、身份认证、跨仓库协调那一套基础设施要求——还没有可以拿来抄的落地案例。
六、还有几个问题没有答案
诚实地留下几条这次研究没回答的问题,因为它们才决定这条路能走多远:
- Agent 集群在需求模糊、约束未固化的真实产品工程里,失败率有多高?没有数据。
- 那 20% 的技术债,累积速度多快、什么时候反噬?没有数据。
- 企业级的合规审计和安全边界,实际实施标准是什么?没有标准。
- AI 生成的代码在极端并发、崩溃恢复、数据迁移场景下稳不稳?没测过。
- 以及最根本的一条:这次结论来自一个任务样本。一次成功的受控实验,还不构成规律。
所以我的判断是:这是一次值得认真读的实验,但它的价值不在“AI 已经能写数据库了”,而在它非常清楚地画出了那条线——
线的这边,是规范确定、验证自动、可以交给机器的部分;线的那边,是想清楚要造什么、扛得住生产、能维护十年的部分。
第一部分正在快速变便宜。第二部分还没有。而你的工作值多少钱,取决于你站在哪一边。
你手上正在做的活儿,属于线的哪一边?评论区聊聊:哪个任务的验收标准,是机器能自动判对错的?