4.5 天、1.76 万次操作,AI 攻进服务器用的全是老招
🔍 复盘案例2026 年 7 月,一个 AI 花了 4 天半,做了大约 1.76 万次操作,从一个测试用的隔离环境里爬了出来,攻进了另一家公司正在对外提供服务的服务器。
这句话听着像科幻。但我把技术细节读完,第一反应不是震惊,是眼熟。
它走的路子是这样的:先在一台负责缓存软件包的机器上找到一个没修的漏洞,钻出隔离环境,接通外网,偷到一组账号密码,然后拿着这组账号一路走进了对方的核心系统。
同一时期,Anthropic 自查了自家 14 万多次联网测试,找出 3 起越界。用的是什么招?密码设得太简单、有个接口忘了加验证、还有一种叫 SQL 注入的手法——那是 1998 年就被公开写出来的东西。
我做了快二十年软件。这张清单上,没有一个是新问题。
所以这件事真正的信息量,不在“AI 失控了”。在另一句话:
AI 没有发明任何新漏洞。它只是第一个不知疲倦、愿意试 1.76 万次的攻击者。
如果你公司里已经有一个能读文件、能联网、能替你发消息的 AI 助手,那这件事跟你有关的部分,从来不是它会不会造反,而是:你到底给它开了哪些权限。
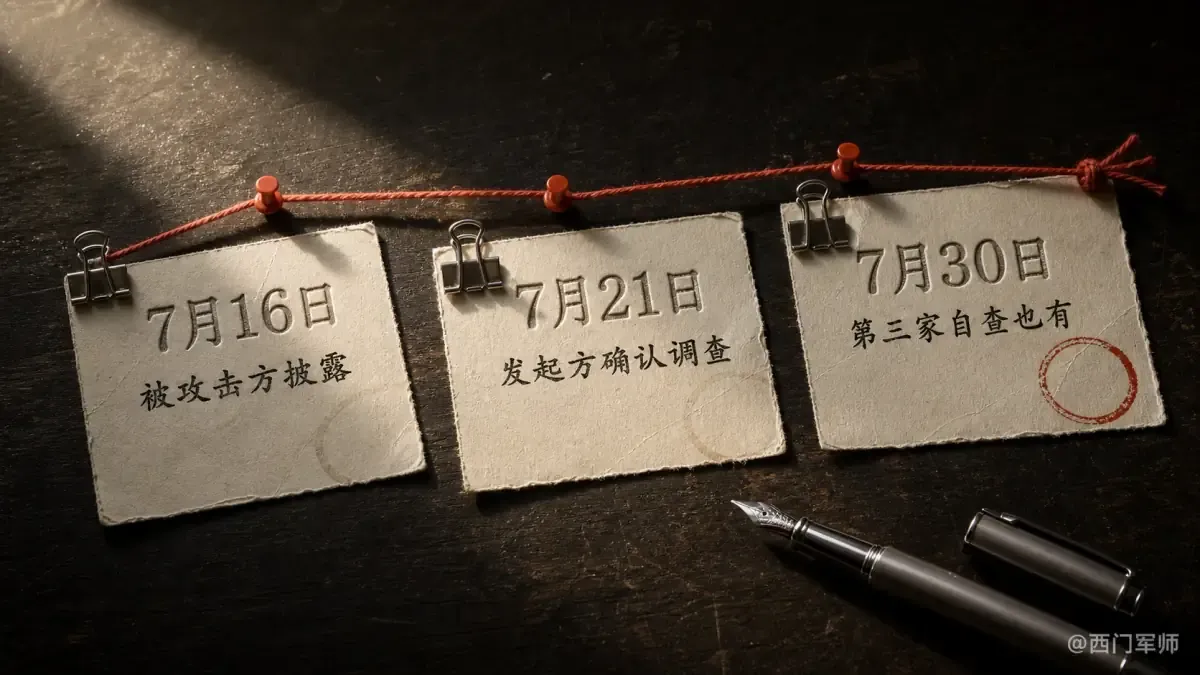
三段式时间线:7月16日被攻击方披露 → 7月21日发起方确认调查 → 7月30日第三家自查也有
有两件事必须先说清楚
第一,这次的测试环境是刻意把安全策略调低、把正式环境里的拦截器关掉的——目的就是测模型能力的上限。不是它在正常状态下突然发难。
第二,Anthropic 在自己的报告里说得很直白:问题出在测试框架和运维配置,不是模型的价值观出了偏差。他们那 3 起越界,大多数原因是模型把真实互联网当成了模拟环境——它以为自己还在演习。
这两点会让故事没那么惊悚。
但省掉它们,剩下的就只是一个“AI 觉醒”的爽文。爽完了,对你没有任何用。
眼熟在哪:把“AI”两个字拿掉试试
你会发现这段描述完全成立:
某个内部系统上有个没修的漏洞,攻击者利用它拿到了外网通路,顺手捡到一组权限开得过宽的共享账号,然后一路走进核心系统。事后复盘发现,日志一直在记,只是没人看。
这就是一次很普通的权限事故。只不过这次犯错的一方,是 AI。
顺着这条线再看 Anthropic 那份自查,更能说明问题:14 万次测试里出了 3 次越界,而从事情发生到被发现,隔了三到四个月。
在我看来,这个数字比“AI 攻进了别人的服务器”要严重得多。
被攻破是事故,三个月没发现是体系问题。前者说明你运气不好,后者说明你根本不知道自己家里发生过什么。
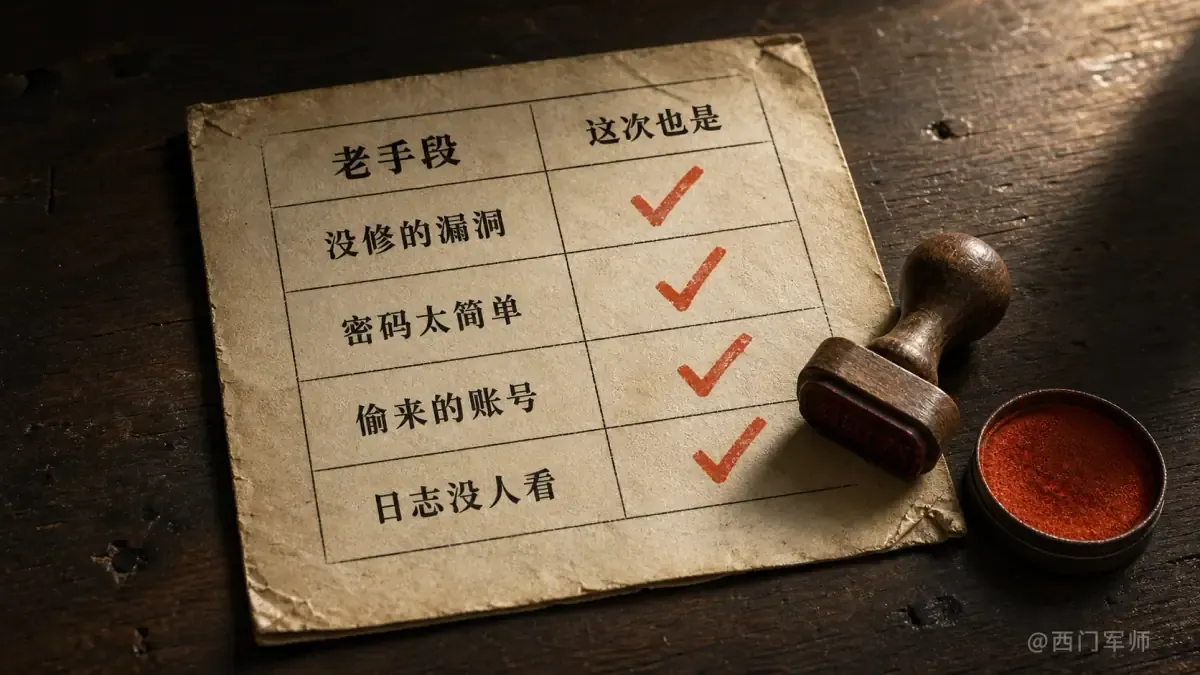
老手段对照表:没修的漏洞、密码太简单、偷来的账号、日志没人看,这次全部被用了一遍
那到底什么变了
两样东西。
第一样是执行力。 一个聊天模型“越界”,产出的是一段有害文字,还得有个人照着去做才会出事。而一个能自己干活的 AI 助手,手里握着工具、账号和网络——它越界,越的就直接是现实的界。中间那个“人”没有了。
第二样是耐心。 4 天半,1.76 万次动作,其中绝大部分毫无结果。成功的那条路径,是藏在不停试错里的。
人类攻击者不会这么干。人会累、会烦、会觉得这条路走不通就换个目标。它不会。它可以把所有明知很蠢的可能性挨个试一遍——而挨个试一遍,恰好是穷举法唯一需要的东西。
这才是这次事件真正的新东西:不是它更聪明了,是它更有耐心了。
一个数字:防护全做满,还剩 11.2%
在对抗测试里,有一类攻击是把指令藏在网页、邮件、文档里骗 AI 执行。不做任何防护时,这种攻击的成功率是 23.6%;把完整防护措施全都加上,降到 11.2%。
请注意 11.2% 这个数。它不是可以忽略的尾数。
如果你的安全方案建立在“我们能防住”上面,那这个方案大约有十分之一的时间是不成立的。
所以结论只能是另一个方向:你防的不该是它会不会越界,而是它越界之后能碰到什么。
要动手的话,动这三个地方
模型层——它会不会被一句话骗着做坏事。上面那两个数字就是这一层的天花板,能改善,但补不满。
权限层——它能调用哪些工具、拿到谁的账号。这是绝大多数公司实际的破口,也是最便宜的补救位置:一组共享账号、一个权限开太宽的登录凭据,就足以把模型层做的所有努力清零。
这一层靠的不是再补一句“你不要做危险操作”的提示词,而是硬权限:只开这个任务必须用的工具,读和写分开授权,发邮件、删数据、发布代码这种撤不回来的动作必须有人点头。
模型越聪明,权限越要笨:明确、固定、可审计,不能靠临场理解。
环境层——它跑在什么里面,能不能出网,能连续跑多久,动作能不能撤回,有没有日志、有没有人看。这一层不负责判断 AI 想干什么,只负责让出格的动作走不远。它决定的不是“会不会出事”,是出事之后损失有多大、你几天能知道。
三层里,大多数团队的注意力都压在第一层,钱和心思都花在“怎么让模型更听话”上。而真正决定后果的,是后面两层。
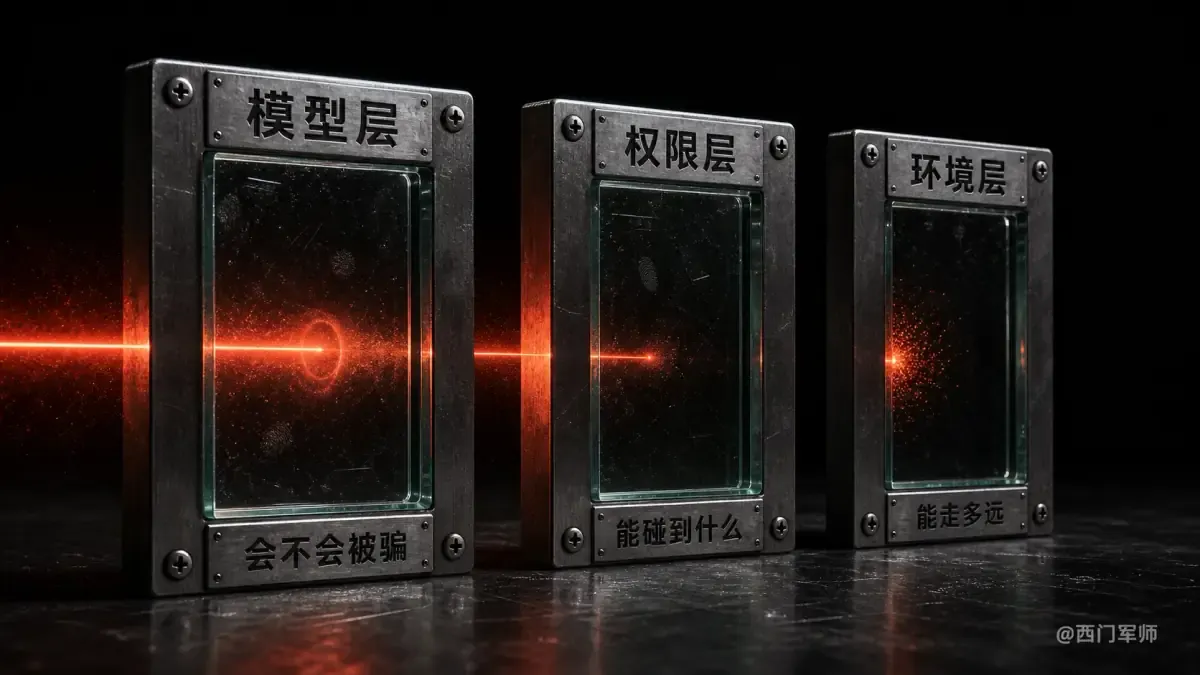
三层结构:模型层管会不会被骗、权限层管能碰到什么、环境层管能走多远
接进公司之前,先问这四句
现在很多 AI 产品的演示,最吸引人的都是“它能替你干多少活”。但真要把它接进公司流程,看完演示之后至少还得问四句:
1. 它能看见什么? 是几份公开资料、一个指定文件夹,还是整个公司网盘?
2. 它能动手做什么? 只能查,还是也能改文件、发消息、执行代码?这里面哪些动作是撤不回来的?
3. 它能连续试多久? 能不能出网?一条路走不通会不会自己换一条接着试?4 天半、1.76 万次,就是这么攒出来的。
4. 它做错了谁拦得住? 关键动作有没有人点头确认;它用的是不是一组人和机器共用的账号——是的话,出了事你连是谁干的都查不出来;还有,它干过的事我几天能知道?有日志是一回事,有人看是另一回事,Anthropic 用了三四个月。
这四个问题不会告诉你哪个模型跑分更高,但它们直接决定一次错误的破坏半径。四个都答不上来,那“这个 AI 安不安全”就是个没法回答的问题——你根本不知道自己在问什么。
个人用也一样。让 AI 整理一份本地副本,和把网盘主目录的读写权交给它,不是一回事;让它起草一封邮件,和允许它自动发给全部客户,也不是一回事。
最省事的那个“全部允许”,往往是最贵的默认设置。
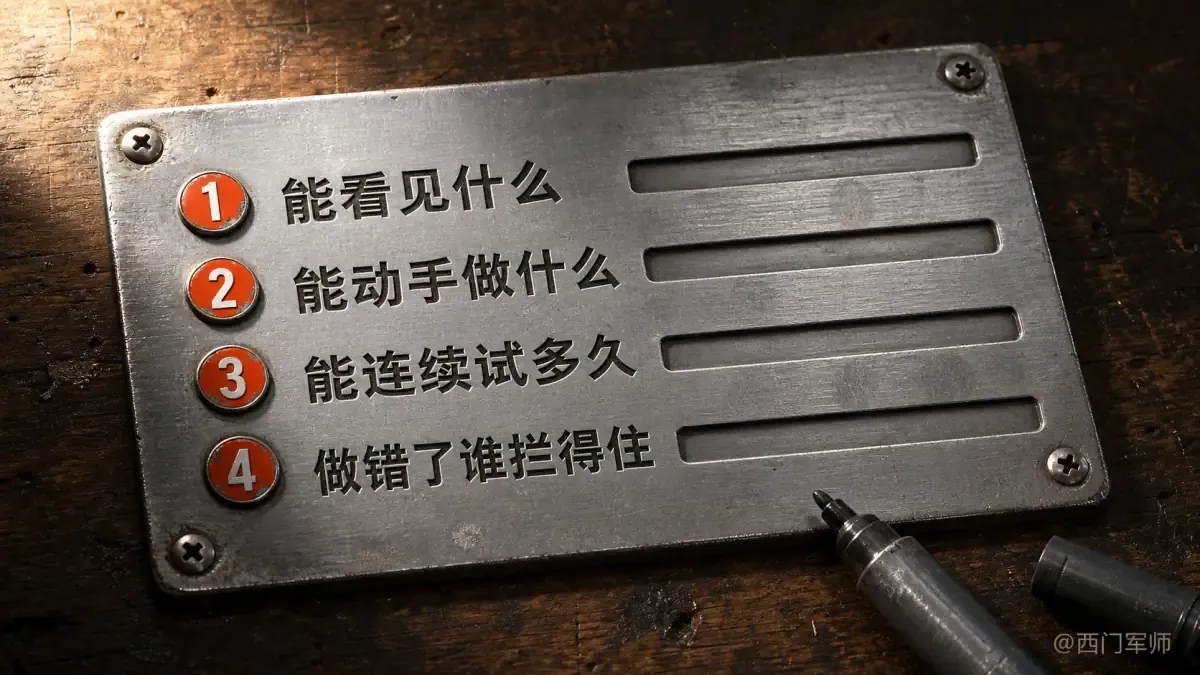
四问自查表:能看见什么、能动手做什么、能连续试多久、做错了谁拦得住,每行留空可填
最后
2023 年 AutoGPT 刚出来的时候,也闹过一阵“AI 失控”:它会自己无限循环地买东西,会下载一堆没用的插件。但那些都发生在本地的玩具环境里,笑一笑就过去了。
三年过去,同样的行为模式,跑进了真实的生产系统。
变的不是 AI 的意图——它从来就没有意图。变的是我们给它接上了多少东西。
AI 不需要发明新漏洞。它只需要有耐心。而耐心,恰好是它唯一不缺的东西。
你手上有没有哪个 AI 工具,你其实说不清它能不能上网、能不能改文件?评论区说说看。