Skill 系列终章:如何从 0 到 1 设计一个真正可用的 Skill
🧭 技术战略这是 Skill 系列的最后一篇,我们来回答一个最关键的问题:
如何从 0 到 1,设计并实现一个真正可用的 Skill?
一、一个 Skill,本质上就是一个结构化的 Markdown 文件
一个最基础的 Skill,其实只需要一个 SKILL.md 文件。
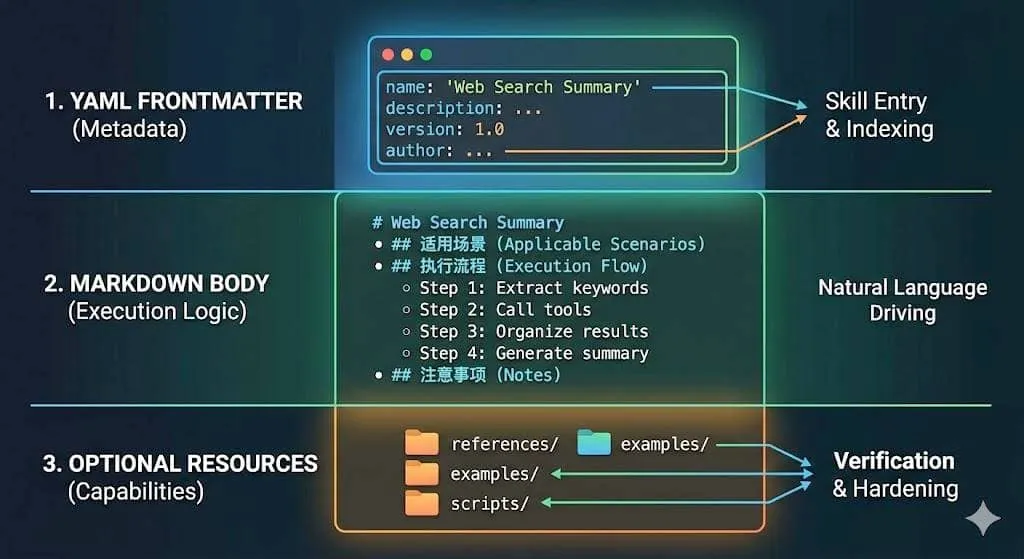
它通常采用 YAML Frontmatter + Markdown 正文 的结构,用于同时描述「技能元数据」和「执行逻辑」。
整个文件可以分为三个部分:
1. YAML Frontmatter(元数据)
位于文件最顶部,采用 YAML 格式,主要包括:
- name
- description
- 其他可选字段(如 version、author 等)
这一部分会被预加载到模型的系统提示词中,它的作用非常关键:
决定这个 Skill 是否会被命中和调用
换句话说,这一层更像是 Skill 的“索引”和“入口”。
2. Markdown 正文(执行指令)
正文部分是 Skill 的核心,通常通过 Markdown 标题进行结构化组织,例如:
- 背景说明
- 执行步骤
- 规则约束
- 注意事项
这里本质上是在定义:
- 大模型的推理规则
- 工作流程
- 行为边界
需要注意的是:
这一层依然是“自然语言驱动”的,因此存在一定不确定性
3. 可选资源(增强能力)
除了 SKILL.md 本身,还可以引入一些辅助资源,用于增强 Skill 的能力:
- references/:引用资料
- examples/:示例输入输出
- scripts/:可执行脚本
这一层的作用是:
把“模糊的能力”变成“可验证的能力”
二、从“概率执行”到“确定性执行”
如果你仔细观察会发现:
- Markdown 定义的是「该怎么做」(偏语义、偏推理)
- scripts 定义的是「具体怎么执行」(偏工程、偏确定性)
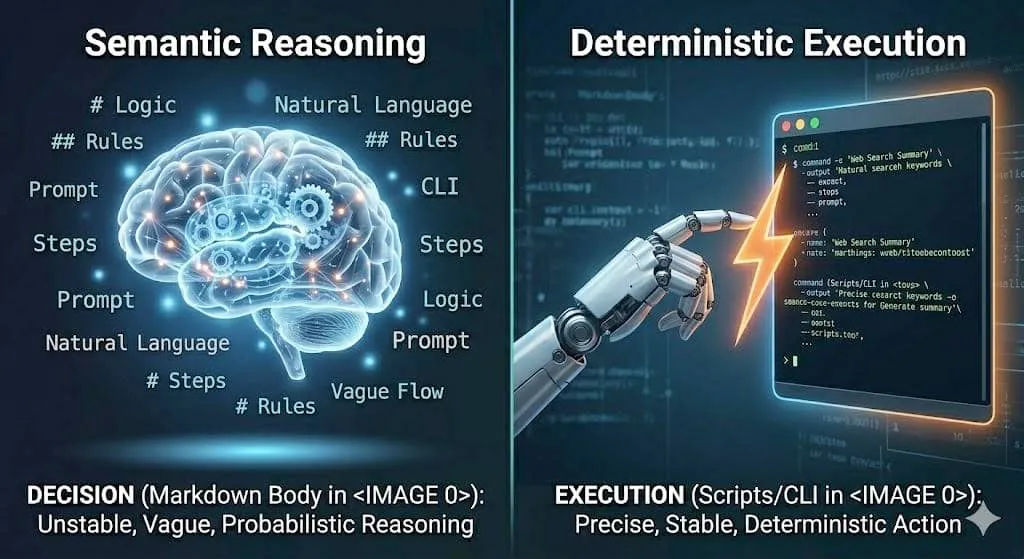
这两者的组合,构成了 Skill 的核心设计思想:
用大模型做决策,用程序做执行
为什么需要 scripts?
因为仅靠 Prompt(即 Markdown),存在天然问题:
- 不稳定(同样输入,可能不同输出)
- 不可验证
- 难以对接真实系统
而通过 scripts/,我们可以把关键步骤“固化”为确定性执行,例如:
- 使用 grep 查找内容
- 调用 CLI 工具处理数据
- 请求远程 API 获取结果
三、一个重要趋势:CLI 化能力封装
在实际工程中,越来越多团队在采用一种模式:
把远程 API 封装成 CLI 工具
然后让多个 Skill 复用同一套 CLI。
这样做有几个明显好处:
1. 解耦 Skill 与 API
- Skill 只关心“调用什么能力”
- CLI 负责“如何调用 API”
2. 提升复用性
- 多个 Skill 可以共享同一个 CLI
- 避免重复定义调用逻辑
3. 增强确定性
- CLI 是强约束的执行单元
- 输出结构稳定、可预期
四、一个完整示例:从 Skill 到 CLI 的落地
讲到这里,我们直接来看一个完整的可落地例子。
场景:用户提问 → 自动搜索 → 总结结果
1️⃣ SKILL.md 示例
---
name: web-search-summary
description: 当用户需要获取最新信息、外部知识或不确定答案时,使用该技能进行搜索并总结结果
version: 1.0.0
---

# Web Search Summary Skill

## 适用场景
当用户的问题:
- 涉及实时信息(新闻、价格、趋势等)
- 超出模型知识范围
- 需要引用外部资料

## 执行流程

### Step 1:提取搜索关键词
- 从用户问题中提取 3~5 个关键词
- 尽量去除无关修饰词
- 保持语义准确

### Step 2:调用搜索工具
使用以下命令进行搜索:

tavily search "<query>"

要求:

- query 为提取后的关键词组合
- 默认返回前 5 条结果

### Step 3:整理搜索结果

- 阅读返回的内容
- 提取关键信息点
- 去重、合并相似内容

### Step 4:生成总结

输出结构:

1. 简要结论(1-2句话)
2. 关键信息点(3-5条)
3. 如有必要,附带来源说明

## 注意事项

- 不要逐条复述搜索结果
- 不要编造未搜索到的信息
- 优先选择权威来源
2️⃣ CLI 示例(Node.js)
#!/usr/bin/env node

import fetch from "node-fetch";

const API_KEY = process.env.TAVILY_API_KEY;

async function search(query) {
  const res = await fetch("https://api.tavily.com/search", {
    method: "POST",
    headers: {
      "Content-Type": "application/json",
      "Authorization": `Bearer ${API_KEY}`
    },
    body: JSON.stringify({
      query,
      max_results: 5
    })
  });

  const data = await res.json();

  data.results.forEach((item, i) => {
    console.log(`\n[${i + 1}] ${item.title}`);
    console.log(item.url);
    console.log(item.content);
  });
}

const args = process.argv.slice(2);

if (args[0] === "search") {
  const query = args.slice(1).join(" ");
  search(query);
} else {
  console.log("Usage: tavily search <query>");
}
3️⃣ 使用方式
chmod +x tavily.js
export TAVILY_API_KEY=your_api_key

./tavily.js search "AI Agent 最新发展"
4️⃣ Skill 是如何驱动执行的?
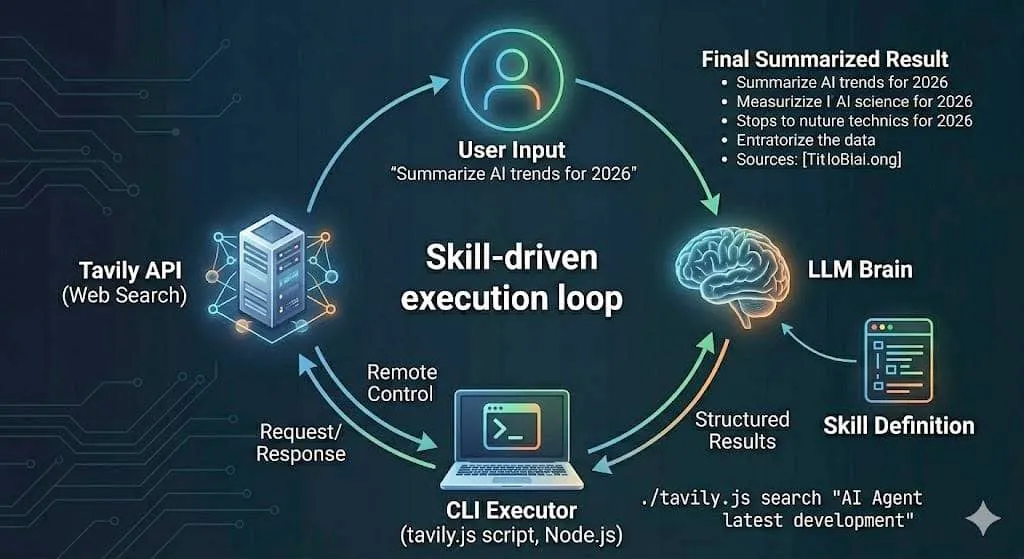
在实际运行中,大模型不会直接执行代码,而是生成“调用指令”:
tavily search "AI Agent 最新发展 2026"系统流程是:
- 执行 CLI
- 获取结果
- 回传给模型
- 模型完成总结
5️⃣ 这个例子说明了什么?
这个简单例子,其实就是 Skill 设计的核心范式:
✅ Skill 负责“决策”
- 什么时候搜索
- 搜什么
- 怎么总结
✅ CLI 负责“执行”
- 如何调用 API
- 如何返回结果
- 如何保证稳定性
✅ 两者通过“文本协议”连接
tavily search "<query>"这就是一个最小但完整的:
LLM ⇄ Tool 协作协议
五、总结:一个可用 Skill 的设计原则
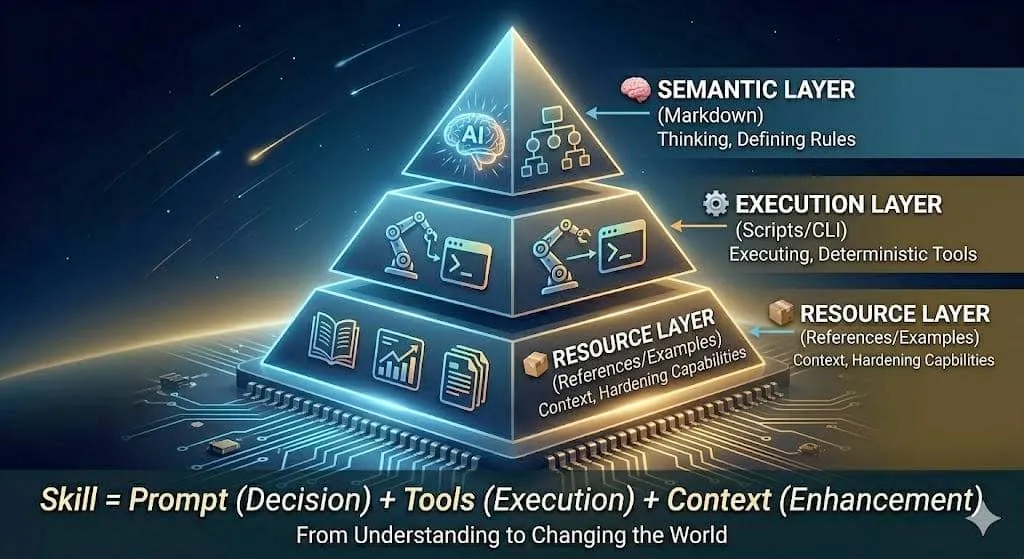
我们可以把一个“真正可用的 Skill”总结为三层结构:
语义层(Markdown)
- 定义规则、流程、策略
- 负责“思考”
⚙️ 执行层(Scripts / CLI)
- 调用工具、执行操作
- 提供确定性能力
资源层(References / Examples)
- 提供上下文支持
- 提升效果与稳定性
最终形成一个完整闭环:
Skill = Prompt(决策) + Tools(执行) + Context(增强)
六、系列收尾:Skill 到底改变了什么?
如果说前两篇解决的是:
- Skill 为什么存在
- Skill 的机制是什么
那么这一篇的核心,是一句话:
Skill 不只是 Prompt,而是一种“可执行能力的工程化封装”。
你写下一个 SKILL.md 的时候,本质上是在定义一个能力的“认知模型”;
而当你为它配上 CLI 的那一刻,这个能力,才真正从:
理解世界 → 走向改变世界。