Skill进阶篇:多 Skill 编排,真正拉开 AI 应用差距的高级能力
🧭 技术战略在理解了 Skill 的基本概念,以及如何从 0 到 1 定义一个 Skill 之后,更进一步的能力,就是 多 Skill 编排。
这往往是 AI 应用开始拉开差距的关键分水岭。
因为优秀的 AI 产品,靠的从来不是“一个模型从头扛到尾”,而是:
在合适的时机,把合适的能力,以合适的顺序,交给合适的执行单元。
这就是多 Skill 编排的本质。
一、先把概念讲清楚
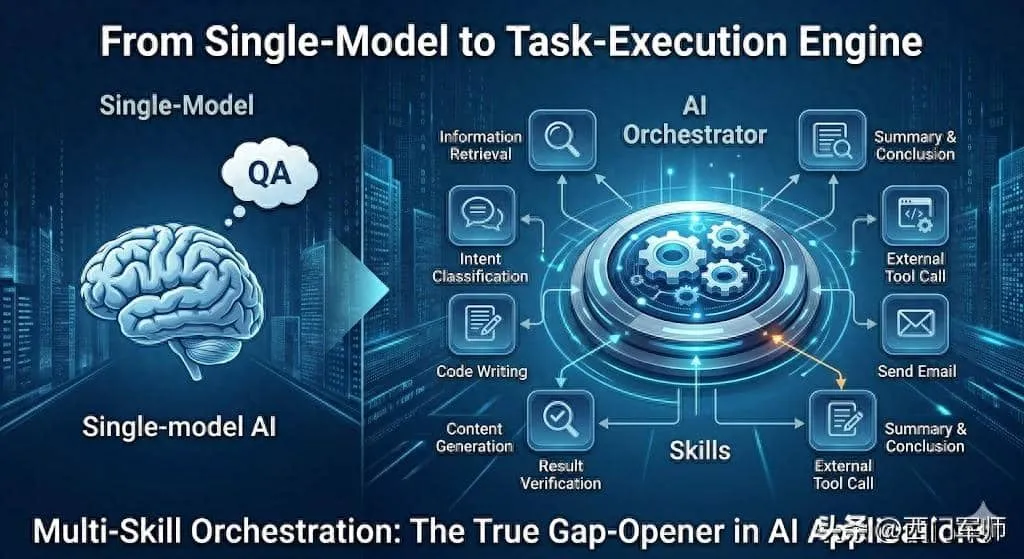
Skill,可以理解为一个可复用的能力模块,例如:
- 检索信息
- 意图分类
- 文案改写
- 内容生成
- 代码编写
- 结果校验
- 总结归纳
- 调用外部工具
- 发送邮件
而所谓 Skill 编排(Orchestration),就是把这些能力模块组合成一套工作流,让系统根据:
- 当前任务类型
- 用户上下文
- 中间执行结果
动态决定下一步调用哪个 Skill。
也就是说,系统不再只是“回答问题”,而是在“执行任务”。
二、AI 应用里最常见的三种编排模式
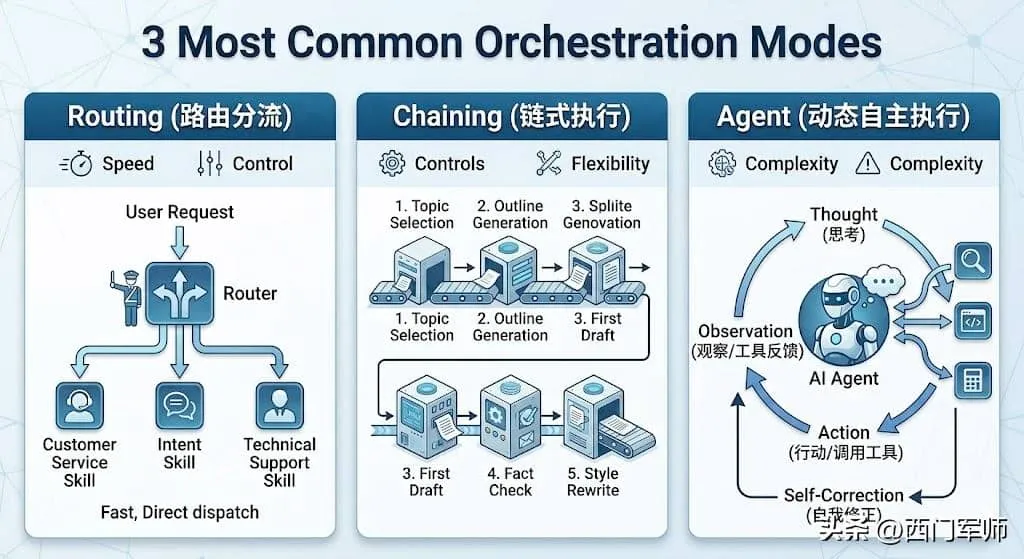
在实际项目中,多 Skill 编排通常有三种形态:
1. Routing(路由分流)
先判断用户请求属于哪一类,再交给对应的 Skill 处理。
本质是:
把请求快速送到最合适的专家。
典型场景:
- 客服分流
- 意图识别
- 多领域问答
- 不同业务线入口分派
优势:
- 响应快
- 结构清晰
- 成本低
风险:
- 一旦路由错,后面全错
2. Chaining(链式执行)
按照预设步骤,一个 Skill 接一个 Skill 执行。
前一步输出,作为下一步输入。
像流水线一样逐步加工结果。
典型场景:
- 写作润色
- 信息抽取
- 报告生成
- 内容审核
- 数据处理流程
优势:
- 稳定可控
- 易调试
- 易优化
风险:
- 错误会逐层传递
3. Agent 化(动态自主执行)
系统根据目标、环境反馈和工具结果,自主决定下一步做什么。
它可能会:
- 调用工具
- 反复尝试
- 自我检查
- 重新规划
- 并行协作
典型场景:
- 开放式复杂任务
- 自动研究助手
- 编程代理
- 多工具协同系统
优势:
- 灵活
- 自适应能力强
风险:
- 难控制
- 易死循环
- 成本更高
三、一个完整编排系统的核心组件
成熟的多 Skill 系统,通常不止有 Skill 本身,还会有一套调度层。
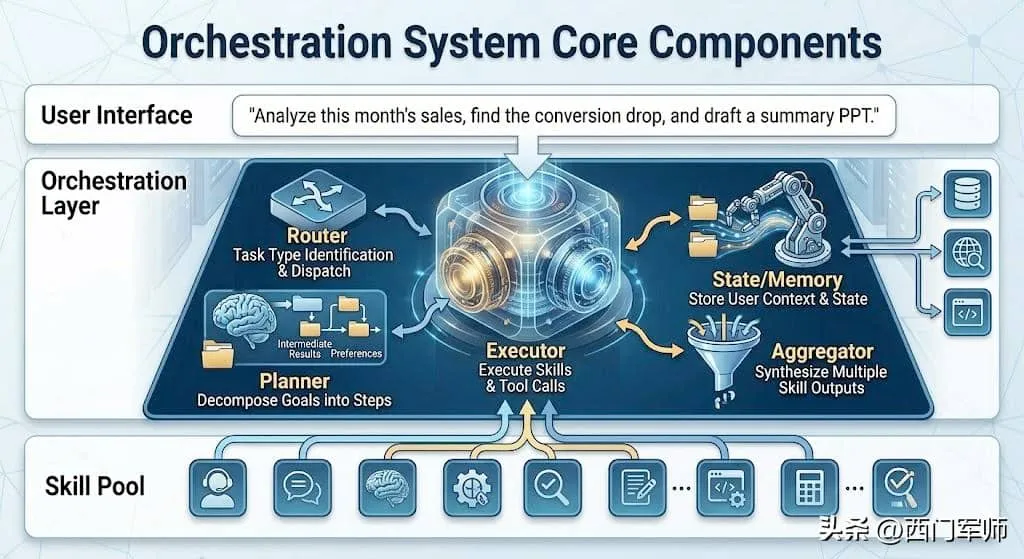
Router(路由器)
判断任务类型,决定交给谁处理。
Planner(规划器)
把复杂目标拆解成多个步骤。
例如:
“帮我做市场分析报告”
拆成:
- 收集数据
- 提炼趋势
- 输出结论
- 生成 PPT
Executor(执行器)
真正执行某个 Skill 或调用工具。
Aggregator(汇总器)
把多个 Skill 的结果整合成统一输出。
Evaluator(评估器)
检查质量,判断是否需要重试、修正或补充。
State / Memory(状态与记忆)
保存:
- 上下文
- 中间结果
- 用户偏好
- 执行进度
- 限制条件
这些组件的加入,意味着系统已经从“单轮对话”,升级为“任务执行引擎”。
四、为什么多 Skill 编排会拉开差距?
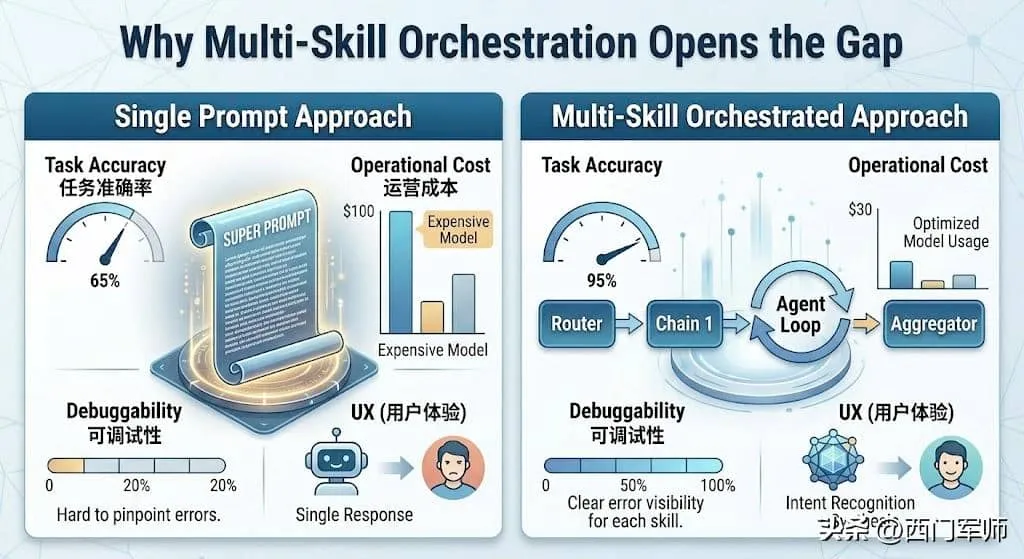
1. 准确率更高
很多问题不是模型不够强,而是流程设计不对。
例如:
- 先分类,再回答
- 先检索,再生成
- 先生成,再校验
通常比一个 Prompt 把所有要求塞进去更稳定。
2. 成本更低
不是所有请求都值得调用最贵模型。
简单问题走轻量 Skill,复杂问题再走高级链路,整体成本会明显下降。
3. 可观测、可调试
你可以清楚知道问题出在哪:
- 路由错了
- 检索错了
- 生成错了
- 校验没过
- 工具失败了
这对于产品迭代极其重要。
4. 产品体验差异巨大
同样一个聊天窗口:
有的产品背后只是单轮问答。
有的产品背后是:
意图识别 + 专家路由 + 检索增强 + 内容生成 + 校验纠错 + 工具执行 + 追问补全
最终体验会完全不同。
五、四个典型应用案例
1. 智能客服分流
用户进入系统后,先由 Router 判断问题类型:
- 退款
- 物流
- 技术支持
- 账号异常
然后分配到不同 Skill。
例如:
退款 Skill → 查订单 + 查规则
技术支持 Skill → 上传日志 + 自动分析
核心价值:
- 降低误答率
- 缩短响应时间
2. 内容生产流水线
流程可以设计为:
- 选题 Skill
- 提纲 Skill
- 初稿 Skill
- 事实核查 Skill
- 平台风格改写 Skill
这就是典型的 Chaining。
它解决的问题是:
把“写得好”拆成多个可优化的步骤。
3. 数据分析助手
用户提问:
为什么本月转化率下降?
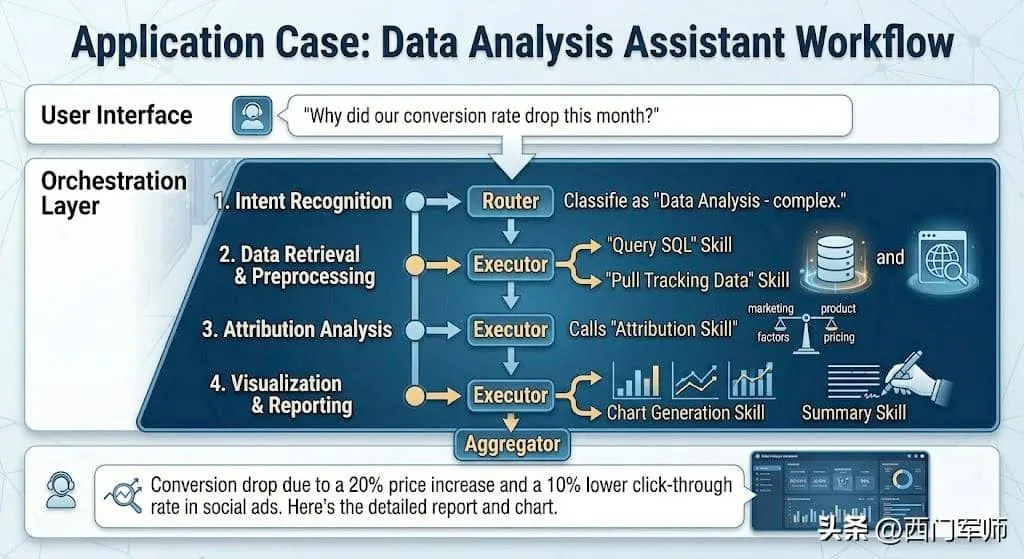
系统可能执行:
- 判断问题类型
- 查 SQL
- 拉取埋点数据
- 做归因分析
- 生成图表
- 输出业务结论
这里常见组合是:
Planner + Executor + Aggregator
4. 代码修复代理
用户提交报错信息后,系统执行:
- 读取日志
- 定位代码
- 修改代码
- 跑测试
- 检查结果
- 失败则继续修复
关键能力不是“会不会修”,而是:
失败后能否持续自我纠正。
这才是真正的 Agent 能力。
六、什么时候该用哪一种?
可以用一个简单判断法:
如果问题像“分诊”
用 Routing
如果问题像“流水线”
用 Chaining
如果问题像“探索任务”
用 Agent
而现实项目里,往往不是三选一,而是混合使用:
先 Routing → 再 Chaining → 必要时进入 Agent 循环
很多成熟系统,本质上都是:
结构化工作流 + 局部 Agent 化
七、设计多 Skill 系统时的两个建议
1. 不要一上来就全做成 Agent
Agent 越自由:
- 越难预测
- 越难控成本
- 越难控延迟
- 越难排查问题
更合理的方式是:
用确定性工作流覆盖 80% 场景,剩下 20% 复杂问题再交给 Agent。
2. Skill 要保持单一职责
一个 Skill 只做一件事。
例如:
- 分类就是分类
- 检索就是检索
- 改写就是改写
- 校验就是校验
编排层负责组合它们。
这样系统才具备:
- 可测试性
- 可替换性
- 可复用性
- 可扩展性
八、结语
单 Skill,解决的是“某个能力能不能做”。
多 Skill 编排,解决的是:
多个能力如何协同,才能形成真正可落地的 AI 产品。
未来 AI 应用的竞争,不只是模型参数规模的竞争。
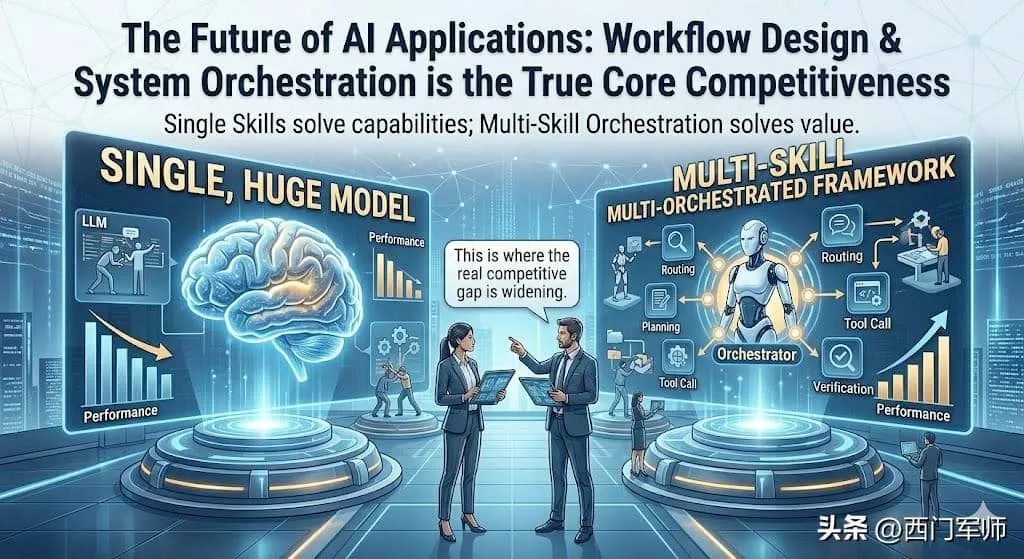
更是:
- 工作流设计能力
- 系统编排能力
- 成本控制能力
- 产品体验能力
谁先掌握多 Skill 编排,谁就更容易做出真正领先的 AI 应用。